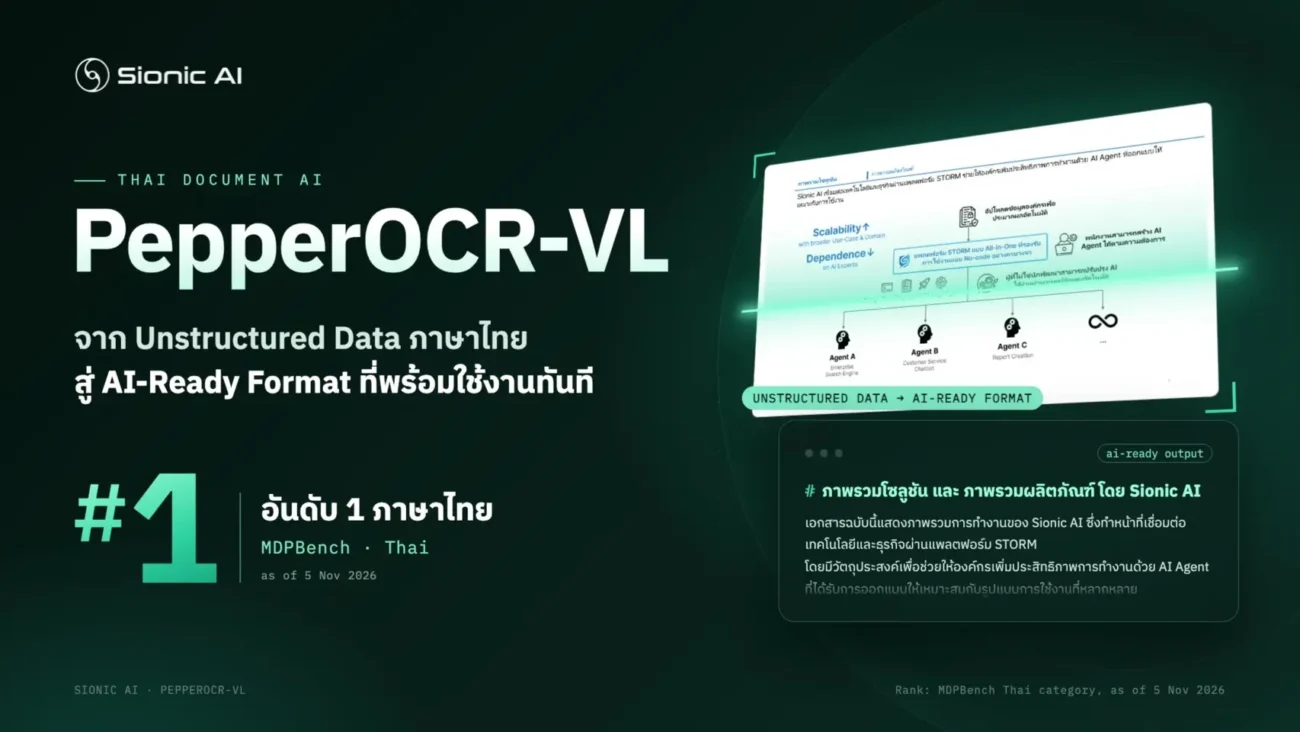
Sionic AI บริษัทด้านปัญญาประดิษฐ์จากเกาหลีใต้ เปิดเผยว่า PepperOCR โมเดลอ่านและแปลงข้อมูลจากเอกสาร ทำคะแนนอันดับ 1 ในหมวดภาษาไทยบน MDPBench เหนือ Google Gemini 3 Pro ในการทดสอบหมวดเดียวกัน โดยบริษัทระบุว่าทีมผู้ดูแลเบนช์มาร์กได้ตรวจสอบและประเมินผลซ้ำแล้ว
MDPBench เป็นชุดทดสอบความสามารถในการเข้าใจเอกสาร 17 ภาษา ครอบคลุมทั้งไฟล์ดิจิทัลและภาพถ่ายเอกสารจากสมาร์ตโฟน สำหรับภาษาไทย ความท้าทายอยู่ที่สระและวรรณยุกต์ที่วางเหนือหรือใต้พยัญชนะ รวมถึงการเขียนโดยไม่เว้นวรรคระหว่างคำ ขณะที่ภาพถ่ายเอียงหรือแสงไม่สม่ำเสมอก็ทำให้อ่านได้ยากขึ้น
PepperOCR ออกแบบมาเพื่ออ่านเอกสารอย่างแบบฟอร์มราชการ ใบแจ้งหนี้ สัญญา และงบการเงิน แล้วแปลงเป็นข้อความและตารางที่นำไปใช้ต่อได้ เช่น จัดทำฐานข้อมูลสำหรับระบบค้นเอกสารภายในองค์กร หรือใช้เป็นข้อมูลให้ AI ค้นเอกสารประกอบการตอบคำถามผ่านระบบ RAG
Sionic AI ระบุว่าโมเดลมีขนาดกะทัดรัดและติดตั้งบนเซิร์ฟเวอร์ภายในองค์กรได้ จึงช่วยลดความจำเป็นในการส่งเอกสารอ่อนไหวออกไปประมวลผลภายนอก นักพัฒนาและองค์กรสามารถดาวน์โหลดโมเดลจาก Hugging Face ไปทดสอบได้ฟรี ภายใต้สัญญาอนุญาต AGPL-3.0
บริษัทมีแผนร่วมมือกับพันธมิตรในไทยเพื่อนำเทคโนโลยีไปใช้แปลงเอกสารในหน่วยงานภาครัฐ ภาคการเงิน และภาคสุขภาพ โดยผลอันดับ 1 ที่ประกาศเป็นผลเฉพาะหมวดการเข้าใจเอกสารภาษาไทยบน MDPBench
